
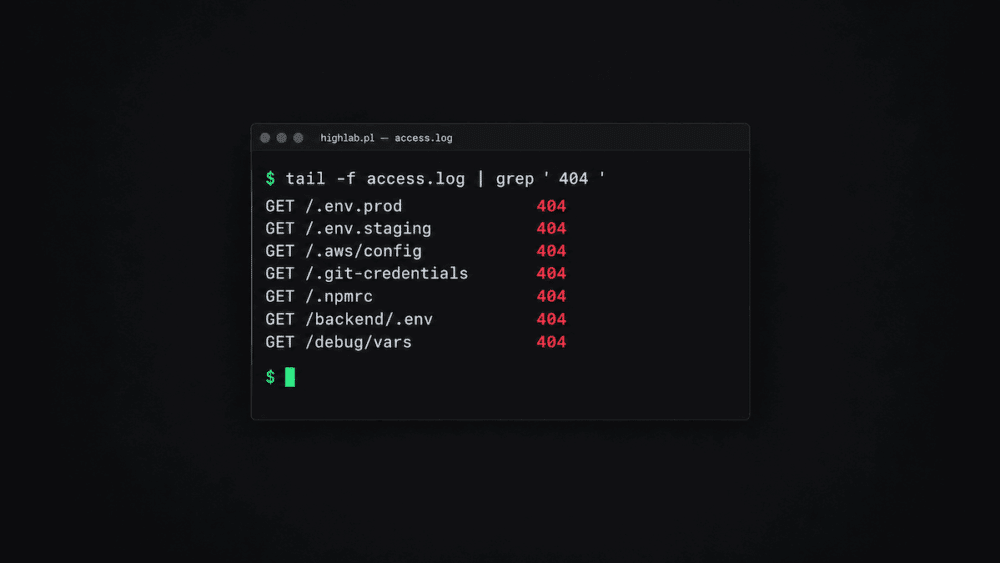
Okazuje się jednak, że logi pokazują coś, czego żadne z tych narzędzi nie pokaże: to, że ktoś (a właściwie coś) regularnie próbuje znaleźć na moim serwerze pliki, których nigdy nie powinno tam być.
Z tego artykułu dowiesz się:
- Boty regularnie skanują popularne ścieżki —
/wp-admin/,/.env,/.npmrc,/.git/config— bez wiedzy, czy dany plik w ogóle istnieje. - W logach 404 mojego bloga jeden bot sprawdził w ciągu jednej minuty 20 różnych ścieżek do plików z sekretami.
- Sam fakt zapytania o
.envto nie problem — problemem byłaby odpowiedź200zamiast404. - Nie każdy automatyczny request to atak — ale kombinacja ścieżki, metody HTTP i kodu odpowiedzi już dużo mówi.
- AI (Claude Code, Codex) świetnie nadaje się do grupowania i analizy dużych logów — pod warunkiem, że nie wklejasz do niego surowych sekretów.
Wszystko zaczęło się od zwykłych błędów 404
Od jakiegoś czasu widziałem w statystykach wejścia na nieistniejące strony. Nic dziwnego — błędy 404 to normalna część życia każdej strony: ktoś kliknie stary link, wpisze zły adres albo trafi na coś, co dawno usunąłem.
Żeby nie gdybać, sprawdziłem, ile takich żądań faktycznie zebrało się w logu Redirection w ciągu czterech dni:
Prawie 90 z ponad 1200 zapisanych żądań trafiało w ścieżki, których na blogu o technologii nikt nigdy nie kliknie z linku. Postanowiłem sprawdzić, co dokładnie generuje te wejścia. Wśród adresów znalazłem między innymi:
/wp-admin/i/wp-login.php/.envw kilkunastu wariantach (.env.production,.env.staging,.env.local…)/.npmrci/.git-credentials/.aws/config
Część z tych plików nigdy na moim serwerze nie istniała. Nie miało to jednak znaczenia — bot nie wiedział, że ich tam nie ma. Po prostu sprawdzał.
Bot nie musi wiedzieć, co masz na serwerze
To chyba najważniejszy wniosek z całej tej analizy. Skaner nie musi najpierw przeanalizować strony i dopiero potem zdecydować, co sprawdzić. Ma gotową listę popularnych ścieżek i odpytuje je po kolei, licząc na to, że trafi.
Dla bota wykonanie kilkudziesięciu prostych żądań jest praktycznie darmowe. GET /.env nic go nie kosztuje — a jeśli trafi choć raz na tysiąc prób, opłaci mu się to z nawiązką.
Prawdziwy przykład z mojego bloga: 20 żądań w jedną minutę
Zamiast opisywać to teoretycznie, pokażę konkretny fragment własnego logu. Jeden request — bot, który w User-Agencie sam się przedstawił jako jscrawler z linkiem do repo na GitHubie — sprawdził w ciągu jednej minuty dwadzieścia różnych ścieżek:
02:04 GET /.env~              → 404
02:04 GET /.env.prod          → 404
02:04 GET /.env.staging       → 404
02:04 GET /.aws/config        → 404
02:04 GET /.env.stage         → 404
02:04 GET /src/.env           → 404
02:04 GET /.env.production    → 404
02:04 GET /.git-credentials   → 404
02:04 GET /api/.env           → 404
02:04 GET /.env.local         → 404
02:04 GET /actuator/env       → 404
02:04 GET /backend/.env       → 404
02:04 GET /actuator/configprops → 404
02:04 GET /.npmrc             → 404
02:04 GET /debug/vars         → 404
Ten sam klient sprawdził przy okazji kilka wariantów phpinfo.php — plik, który potrafi ujawnić sporo szczegółów o konfiguracji serwera, jeśli ktoś zapomni go usunąć po debugowaniu.
Ścieżki /actuator/env i /actuator/configprops to nie WordPress, tylko endpointy Spring Boota (Java). Ten sam bot w minutę sprawdza serwer WordPressa i serwer Javy tym samym skryptem — nie profiluje ofiary, tylko odpytuje uniwersalną listę.
Dlaczego akurat .env i .npmrc?
Plik .env w wielu aplikacjach webowych przechowuje zmienne środowiskowe — hasła do bazy, klucze API, tokeny. .npmrcmoże zawierać dane dostępowe do prywatnych rejestrów npm. .aws/config i .git-credentials mówią same za siebie.
Żaden z tych plików nie powinien być dostępny przez HTTP. Jeśli serwer odpowie na GET /.env kodem 200 i zwróci zawartość, problemem nie jest już to, że bot go znalazł — problemem jest to, że serwer WWW w ogóle miał co zwrócić. Bot tylko wykorzystał błąd konfiguracji, który już tam był.
To dobry argument za tym, żeby nie patrzeć na bezpieczeństwo strony wyłącznie przez pryzmat samego WordPressa. Można mieć porządnie zabezpieczony panel administracyjny i jednocześnie zostawić w katalogu publicznym plik, który przy deployu w ogóle nie powinien tam trafić.
Najlepszym zabezpieczeniem przed wyciekiem .env nie jest nadzieja, że bot go nie znajdzie, tylko upewnienie się, że serwer WWW nie ma technicznej możliwości go zwrócić — plik poza katalogiem publicznym, zablokowany dostęp po rozszerzeniu/nazwie na poziomie serwera, sekrety niecommitowane do repozytorium.
69 razy /admin, za każdym razem inny User-Agent
Drugi przykład z tych samych logów jest ciekawszy, bo pokazuje inny wzorzec. Ten sam adres — /admin — dostał w ciągu jednego dnia 69 żądań. Wszystkie metodą POST, nie GET. To już nie jest samo „sprawdzenie, czy coś tam jest” — POST sugeruje próbę wysłania danych logowania.
Ciekawe jest też to, że User-Agent za każdym razem wyglądał inaczej: raz Windows i Chrome, raz Linux, raz macOS, raz iPhone. Prawdziwy odwiedzający raczej nie zmienia urządzenia między kolejnymi próbami logowania w ciągu tego samego dnia — to typowy sygnał automatu, który celowo rotuje nagłówki, żeby wyglądać jak różni, przypadkowi użytkownicy.
404 nie zawsze jest tylko błędem
Normalnie traktuję 404 jako problem użytkownika — ktoś wszedł na nieistniejącą stronę. Ale seria: /.env → 404, /.npmrc→ 404, /.git-credentials → 404, /admin → 404 (albo POST bez odpowiedzi) to już nie błędy w tym samym sensie. To informacja o tym, co interesuje automaty krążące po internecie.
Status HTTP ma znaczenie
GET /.env → 404 oznacza coś zupełnie innego niż GET /.env → 200. Podobnie GET /admin → 301 jest ciekawe, jeśli przekierowuje do realnie istniejącego panelu, a GET /admin → 403 mówi, że zasób prawdopodobnie istnieje, tylko dostęp został zablokowany.
Dlatego analizując logi, nie patrzyłbym wyłącznie na to, czy ktoś próbował pobrać dany plik, tylko na kombinację: ścieżka + metoda HTTP + kod odpowiedzi + częstotliwość + to, czy te same żądania powtarzają się z wielu źródeł.
Jak rozpoznać automatyczne skanowanie
Nie ma jednego pola, które mówi „to bot”. Są za to wzorce, które trudno pomylić z zachowaniem człowieka:
- Jeden klient sprawdza kilkanaście różnych ścieżek w ciągu kilku sekund (jak w przykładzie z
jscrawlerwyżej). - Ten sam endpoint dostaje dziesiątki żądań w krótkim czasie, z rotowanymi nagłówkami (jak przy
/admin). - Żądania nie mają sensownego referera — nikt nie kliknął linku, request pojawił się „znikąd”.
- Metoda i ścieżka nie pasują do struktury strony —
POSTna adres, którego formularz logowania nigdy nie istniał.
„Bot” nie znaczy automatycznie „atakujący”. Botami są też crawlery wyszukiwarek, narzędzia SEO, monitoring dostępności czy skanery bezpieczeństwa uruchamiane przez samych właścicieli stron. Requesty do /.env czy /.git/config są jednak zdecydowanie warte uwagi, zwłaszcza w takim wzorcu jak wyżej.
Jakie logi w ogóle warto oglądać
W zależności od infrastruktury, ciekawe mogą być:
- Logi serwera WWW —
access.log,error.log: kto, co, kiedy i z jakim skutkiem próbował pobrać. - Logi WordPressa — błędy PHP, nieudane logowania, błędy wtyczek i motywu.
- Logi WAF/CDN, jeśli z takiego korzystasz — pokażą ruch odrzucony, zanim w ogóle dotarł do WordPressa.
- Logi SSH, jeśli masz własny serwer — próby dostępu na poziomie systemu, nie tylko aplikacji.
Od czego zacząć
Nie trzeba od razu budować systemu SIEM. Na start wystarczy prosty proces:
- Włącz logowanie 404 (w WordPressie wystarczy do tego wtyczka Redirection).
- Zbieraj dane przez kilka dni albo tygodni.
- Posortuj żądania według liczby wystąpień i zobacz, co powtarza się najczęściej.
- Zwróć szczególną uwagę na
.env,.git,.npmrc, pliki konfiguracyjne, panele logowania i kopie zapasowe. - Sprawdź status HTTP — a zwłaszcza, czy któryś z wrażliwych adresów kiedykolwiek zwrócił
200.
Tu wchodzi AI
Jeszcze kilka lat temu ręczna analiza dużego pliku logów była żmudna. Dziś narzędzia takie jak Claude Code czy Codex potrafią w chwilę pogrupować requesty według ścieżek, policzyć najczęściej skanowane endpointy albo wskazać nietypowe wzorce w danych, które mają setki czy tysiące wierszy — dokładnie tak, jak przy analizie pliku, który stał się punktem wyjścia do tego artykułu.
Zamiast ręcznie przeglądać cały log, wystarczy poprosić agenta: „przeanalizuj ten plik, pogrupuj żądania według celu i wskaż wzorce, które mogą mieć znaczenie z punktu widzenia bezpieczeństwa”. To nie zwalnia z podejmowania decyzji — ale świetnie przyspiesza pierwszy etap, czyli zorientowanie się, co w ogóle jest w danych.
Logi mogą zawierać adresy IP, identyfikatory sesji, tokeny czy fragmenty URL-i z parametrami. Zanim wkleisz je do zewnętrznego narzędzia, sprawdź, co faktycznie w nich jest — i nie przekazuj haseł, cookies sesyjnych ani kluczy API, nawet jeśli narzędzie ma tylko „pogrupować dane”.
Czy warto robić to regularnie?
Zależy od skali. Na małym blogu nie ma sensu codziennie czytać access.log linijka po linijce — wystarczy okresowo sprawdzić najczęściej żądane adresy, monitorować nietypowe wzrosty ruchu i upewnić się, że nic wrażliwego nie jest publicznie dostępne. Przy większej aplikacji sensowniejsza jest centralizacja logów, alerty i automatyczne reguły — ale to już zupełnie inna skala problemu niż blog na WordPressie.
Najważniejsza rzecz, jaką dały mi logi 404
Chciałem tylko sprawdzić, skąd biorą się błędy 404. W praktyce zobaczyłem fragment tego, jak mój blog wygląda z perspektywy automatycznych skanerów. Nie interesowały ich artykuły — interesowały je potencjalne punkty wejścia i pliki, które mogłyby zawierać coś wartościowego.
Logi są trochę jak kamera skierowana na drzwi serwera. Nie pokażą wszystkiego i nie powiedzą, czy dana próba się powiodła — ale pokażą, czego szukają automaty, i czy przypadkiem nie zostawiłeś gdzieś czegoś, czego szukają skutecznie.
Nie analizuję logów dlatego, że zakładam, że ktoś właśnie próbuje włamać się na mój serwer. Analizuję je dlatego, że pokazują mi, jak mój serwer wygląda z perspektywy internetu.
FAQ
01Czy boty naprawdę skanują pliki takie jak .env?+
.env nie oznacza, że plik istnieje ani że doszło do wycieku — kluczowe jest to, jak odpowiedział serwer. 404 oznacza, że zasobu nie znaleziono; 200 mogłoby oznaczać, że plik faktycznie został zwrócony.

