Claude Code v2.1.319 na macOS, listopad 2026. Przykłady pochodzą z repozytorium motywu highlab.pl: WordPress, PHP, ok. 1100 wpisów i własne narzędzia do migracji treści.
W skrócie
- CLAUDE.md to to, co agent musi wiedzieć przy każdym zadaniu: komendy, pułapki, konwencje. Każda reguła z powodem.
- Skills to procedury na żądanie. Agent widzi tylko ich nazwę i opis, a resztę ładuje dopiero wtedy, gdy zadanie pasuje.
- Hooks to reguły, które muszą zadziałać zawsze. Uruchamia je Claude Code, a nie model, więc model nie może o nich „zapomnieć”.
- AGENTS.md to ten sam pomysł dla Codexa, Cursora i innych. Od 18 września 2026 Claude Code czyta go sam, gdy w projekcie nie ma CLAUDE.md.
Czym jest CLAUDE.md i gdzie go położyć
CLAUDE.md to zwykły plik Markdown. Claude Code dokleja go do kontekstu na starcie sesji, więc model „wie” to, co w nim jest, zanim napiszesz pierwsze polecenie. Plików może być kilka, a Claude Code łączy je od najbardziej ogólnego do najbardziej szczegółowego:
| Plik | Dla kogo | Do gita? |
|---|---|---|
~/.claude/CLAUDE.md |
Ty, we wszystkich projektach (język odpowiedzi, Twoje nawyki) | nie |
./CLAUDE.md lub ./.claude/CLAUDE.md |
cały zespół w tym projekcie | tak |
CLAUDE.md w podkatalogu |
tylko praca w tym katalogu (wczytywany, gdy agent sięga po pliki z niego) | tak |
Najszybszy start to komenda /init: Claude Code przegląda repozytorium i pisze pierwszą wersję pliku, a /memory otwiera go do edycji. W pliku można też dołączać inne pliki składnią @ścieżka/do/pliku.md, dzięki czemu długie opisy nie muszą siedzieć w samym CLAUDE.md.
Jedna rzecz, o której łatwo zapomnieć: cały plik trafia do kontekstu w każdej sesji, także wtedy, gdy poprawiasz literówkę w CSS. Każde zdanie w CLAUDE.md to tokeny wydawane za każdym razem. Więcej o tym, jak to ograniczać, pisałem w tekście jak zmniejszyć zużycie tokenów w Claude Code.
Co wpisywać do CLAUDE.md: przykłady z mojego pliku
CLAUDE.md w repozytorium tego bloga ma dziś 134 linie i ok. 4100 słów (31 tys. znaków). Nie powstał na raz. Prawie każdy akapit dopisałem po tym, jak agent zrobił coś źle albo jak sam straciłem czas na tę samą rzecz drugi raz. Z tych 25 wersji wyszło pięć rodzajów wpisów, które naprawdę działają.
1. Fakty o środowisku, których agent nie zgadnie
- DB: MySQL lokalny, root/root, host 127.0.0.1, baza highlab_portal,
  **prefiks tabel wp_highlab** (bez podkreślenia między prefiksem
  a nazwą tabeli → wp_highlabposts, nie wp_highlab_posts).
Bez tej linii agent za każdym razem zakładał standardowe wp_highlab_posts, dostawał błąd i szukał dalej. Jedno zdanie oszczędza kilka wywołań na sesję. Dopisuj tu wszystko, co jest nietypowe: niestandardowy port, komendę zamiast globalnego narzędzia, katalog, z którego trzeba uruchamiać serwer.
2. Pułapki z historią: co się stało i dlaczego
**Pułapka, na którą już wpadliśmy:** plik wyniku MUSI być per wykonanie.
Przy jednym stałym result.jsonl drugi przebieg tego samego planu daje
same noop i nadpisuje ślad po applied — revert nie ma wtedy czego cofać.
Sam zakaz („nie używaj stałego pliku wyniku”) agent stosuje dosłownie. Zakaz z powodem pozwala mu rozpoznać ten sam błąd w innej formie, np. w nowym narzędziu, którego reguła nie wymienia. Z mojego doświadczenia to najważniejsza zasada pisania CLAUDE.md: każda reguła ma „bo…”.
3. Zakazy z datą i dowodem
**Spis treści: numer sekcji z CSS, nie z DOM.** Numer jako osobny element
w linku Google sklejał z tytułem w snippecie („02Dane techniczne…”,
17 paź 2026). Nie wracaj do numeru w treści linku.
Taki zakaz chroni przed „ulepszeniem”, które agent uważa za oczywiste. Numer w HTML wygląda czyściej niż numer z CSS, więc bez tej linii prędzej czy później ktoś (człowiek albo model) by go przywrócił. Data pozwala za pół roku ocenić, czy powód jest nadal aktualny.
4. Sprzężenia w kodzie
…formuła jest więc w dwóch miejscach (PHP i common.js),
**zmieniając jedną, zmień drugą**.
Agent, który poprawia jeden plik, nie widzi, że gdzieś indziej jest jego bliźniak. To najtańsza reguła, jaką można dopisać, i najdroższa, kiedy jej brakuje: rozjazd wyniku między serwerem a przeglądarką wychodzi dopiero u czytelnika.
5. Warunki zamiast poleceń
Pi niedostępne (poza domem) → pomiń board i powiedz o tym.Instrukcje typu „zawsze aktualizuj X” kończą się tym, że agent próbuje w kółko albo udaje, że się udało. Dopisanie, co zrobić, kiedy się nie da, działa zaskakująco dobrze. Przy pisaniu tego tekstu agent dokładnie tak zrobił: nie dostał odpowiedzi z Raspberry Pi, przerwał synchronizację i napisał mi, czego nie zrobił.
Czego nie wpisywać
- Tego, co widać w kodzie. Lista plików czy opis funkcji się zdezaktualizuje, a agent i tak przeczyta kod. Lepiej wskazać, gdzie szukać.
- Ogólników w stylu „pisz czysty kod” czy „dbaj o bezpieczeństwo”. Model i tak tak uważa, a to tylko tokeny.
- Historii decyzji. U mnie żyje w osobnym pliku planu, a CLAUDE.md ma do niej tylko link i zdanie, żeby nie traktować jej jako stanu kodu.
- Haseł i kluczy. Wystarczy ścieżka do pliku z danymi logowania poza repozytorium.
Ile to za dużo?
Często spotykana rada to maksymalnie 200–300 linii. Według niej mój plik mieści się z zapasem, bo ma 134 linie. Tylko że liczba linii w Markdownie niewiele mówi: cały akapit to jedna linia, a najdłuższa u mnie ma ponad 3 tys. znaków. Po zawinięciu tekstu do 100 znaków ten sam plik ma 421 linii. Lepiej patrzeć na znaki albo tokeny, bo to one trafiają do kontekstu. Claude Code ostrzega przy dużym pliku CLAUDE.md (ok. 40 tys. znaków), a mój ma 31 tys.
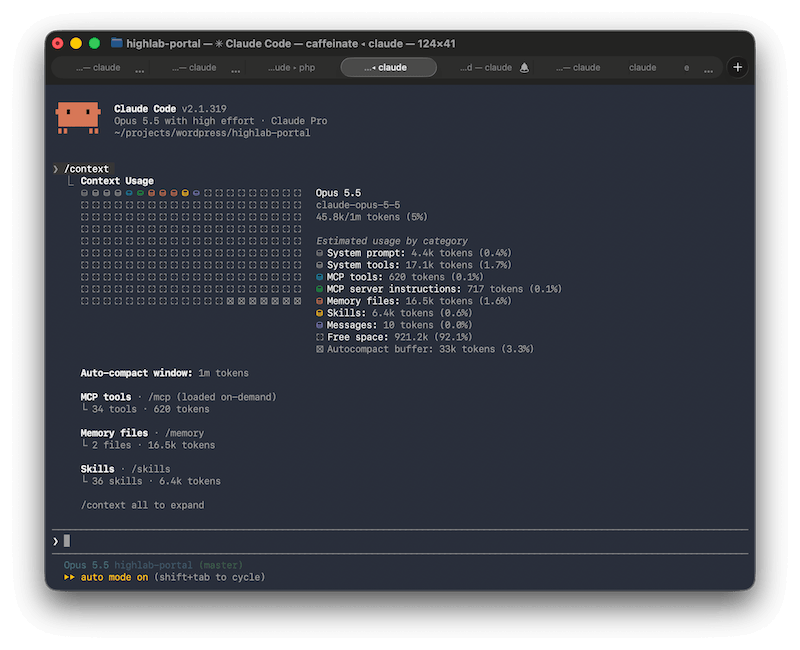
Komenda /context w świeżej sesji pokazuje, ile to kosztuje naprawdę: pliki pamięci (CLAUDE.md i krótki indeks notatek agenta) zajmują 16,5 tys. tokenów, z czego prawie wszystko to CLAUDE.md. To ok. 36% wszystkiego, co agent dostaje na start (45,8 tys. tokenów razem z promptem systemowym, narzędziami i skillami), ale tylko 1,6% okna kontekstu o rozmiarze 1 mln tokenów. Przy oknie 200 tys. byłoby to już ok. 8%. Po drodze wyszło coś, czego się nie spodziewałem: polski tekst jest drogi. 31 tys. znaków to ok. 16 tys. tokenów, czyli mniej więcej 2 znaki na token, a w tekście angielskim zwykle wychodzi ok. 4.
Moim zdaniem ta długość jest jeszcze w porządku, ale to okolice górnej granicy. Przy ok. 4100 słowach nie widzę, żeby agent gubił reguły z końca pliku. Częściej myli się, gdy dwie sekcje opisują to samo inaczej. Mimo to największe sekcje, potrzebne tylko przy jednym rodzaju zadań, to kandydaci na skills (o tym niżej).
Dlaczego CLAUDE.md nie wystarczy: historia z adresem e-mail
5 listopada 2026 na GitHubie Claude Code pojawiło się zgłoszenie (#107757), które w kilka godzin zebrało kilkaset reakcji. Claude Code dostawał w kontekście adres e-mail zalogowanego konta, żeby nie zmyślał autora np. w komentarzach w kodzie. Kiedy jednak model sam pisał zapytanie curl, czasem wstawiał ten adres do nagłówka User-Agent jako kontakt. Niektóre serwisy, np. Wikipedia, proszą automatycznych klientów o podanie kontaktu, a model nauczył się, że tak wygląda „grzeczny” klient. Adres trafiał do przypadkowych stron, a zgłaszający pisali o fali spamu.
Sprawdziłem logi serwera highlab.pl z ośmiu dni (30 października – 6 listopada 2026), żeby zobaczyć, czy ktoś zostawił adres u mnie. Adres e-mail w nagłówku User-Agent miało 17 różnych klientów i każdy z nich był botem, który podpisuje się celowo: crawlery firm SEO, katalogów agentów AI, uczelni. Śladu cudzego Claude Code nie znalazłem, co pasuje do mechanizmu, bo highlab.pl nie prosi o kontakt w nagłówku. Najlepiej podsumowuje to bot, który przedstawił się jako ContactCrawler, a w miejscu adresu podał wymyślony, nieistniejący. Zbieracze adresów też chodzą po blogach.
Ważniejsze jest to, jak to naprawiono. Pierwszą poprawką nie było kolejne zdanie w instrukcjach, tylko hook. Anthropic dodał do Claude Code (od wersji 2.1.317) wbudowany dodatek cc-plugin-privacy, a jego kod opublikował w repozytorium Claude Code. Hook odrzuca wywołanie Basha lub PowerShella, w którym jest adres konta i wzmianka o User-Agent (User-Agent, curl -A, wget -U). Jest szybki i prosty, ale sam opis dodatku uczciwie mówi: „to uprzejmość, a nie granica, i obejmuje jeden przypadek”. Według README przechodzi adres w samym URL albo w treści zapytania, bez nagłówka. Przechodzą też wywołania WebFetch, WebSearch i narzędzi MCP, które nie są w ogóle sprawdzane, oraz adres wyliczany w trakcie, np. $(git config user.email). Użytkownicy w tym samym wątku pokazali też testy, w których blokada nie zadziałała nawet w podstawowym przypadku, a Anthropic zapowiedział, że po prostu usunie adres z kontekstu modelu.
Z tej historii wynikają dwie zasady, które stosuję:
- Jeśli złamanie reguły kosztuje (dane, pieniądze, produkcja), reguła idzie do hooka, a nie do CLAUDE.md. Tekst model zwykle stosuje, ale „zwykle” to za mało przy danych osobowych.
- Hook trzeba przetestować tak, żeby niczego przy tym nie wysłać. Do tego nadaje się domena
.invalid, która z definicji się nie rozwiązuje.
Hooks: reguły, które działają zawsze
Hook to polecenie (skrypt), które Claude Code uruchamia sam w określonym momencie: przed użyciem narzędzia (PreToolUse), po nim (PostToolUse), po wysłaniu polecenia (UserPromptSubmit), na koniec odpowiedzi (Stop) i w kilku innych. Działa to jak webhook, tylko lokalnie: zdarzenie → Twój skrypt. Skrypt dostaje na wejściu JSON z opisem wywołania. Jeśli przy PreToolUse zakończy się kodem 2, wywołanie jest blokowane, a to, co wypisał na stderr, wraca do modelu jako wyjaśnienie.
Hooki, które mają sens na start: formatowanie pliku po każdej edycji (PostToolUse z Edit|Write) i powiadomienie, kiedy agent czeka na Twoją decyzję. Przy długich sesjach przyda się też caffeinate na macOS, żeby Mac nie uśpił się w środku zadania.
Skills: procedury, które agent ładuje, kiedy trzeba
Skill to katalog z plikiem SKILL.md (i ewentualnie skryptami czy szablonami), np. .claude/skills/brief-wpisu/SKILL.md w projekcie albo ~/.claude/skills/… dla wszystkich projektów. Na początku pliku jest nagłówek z nazwą i opisem, czyli frontmatter:
---
name: brief-wpisu
description: Brief danych przed poprawą wpisu na highlab.pl. Użyj, gdy
  użytkownik prosi o poprawienie, odświeżenie albo przepisanie wpisu.
---

1. Uruchom tools/gsc/gsc-brief.php --slug=<slug> …
2. Fraza główna do tytułu i H1, luki → nowe sekcje, pytania → sekcja FAQ.
3. …
Różnica wobec CLAUDE.md jest jedna, ale istotna: w kontekście siedzi tylko name i description, a treść skilla agent wczytuje dopiero wtedy, gdy zadanie pasuje do opisu albo gdy wywołasz go wprost (/brief-wpisu). Dlatego opis musi mówić, kiedy skilla użyć, a nie tylko, co robi. Skills działają też w aplikacji Claude i w API, stąd tyle wyszukiwań „claude skills” niezwiązanych z programowaniem.
Mój CLAUDE.md jest tu dobrym przykładem tego, czego nie robić. Sekcje o migracjach treści i o poprawianiu wpisów to razem ok. 2400 słów, czyli 59% pliku. Wczytują się do każdej sesji, także wtedy, gdy pracuję nad stylem przycisku. To typowi kandydaci na skills: procedury krok po kroku, potrzebne przy jednym rodzaju zadań.
Jedyny skill, który mam skonfigurowany globalnie, to /grill-me. Nie wyobrażam sobie pracy bez niego w żadnym projekcie. Dzięki niemu jestem w stanie bardzo szybko wykryć zależności pomiędzy kawałkami kodu czy funkcjonalności. W efekcie jedna zmiana jest sprawdzana kompleksowo w wielu miejscach. Efekt końcowy jest znacznie lepszy.
Uwaga przy cudzych skillach: to instrukcje, a często też skrypty, które agent wykona na Twoim komputerze. Katalogi z tysiącami gotowych skilli to wygoda, ale przed instalacją warto przeczytać SKILL.md i to, co jest obok.
Subagenty w dwóch zdaniach
Subagent to osobny agent z własnym promptem, listą narzędzi i modelem, zdefiniowany w pliku .claude/agents/<nazwa>.md. Przydaje się, gdy zadanie wymaga przekopania wielu plików, a do głównej rozmowy ma wrócić tylko wniosek, co oszczędza kontekst. Pamiętaj, że każdy subagent startuje od zera i zużywa własne tokeny.
AGENTS.md a CLAUDE.md
AGENTS.md to otwarty format tego samego pliku z instrukcjami, który czytają m.in. Codex od OpenAI i Cursor (o innych edytorach z AI pisałem przy Windsurfie). Od 18 września 2026 obsługuje go też Claude Code: jeśli w projekcie nie ma CLAUDE.md, czyta AGENTS.md (zmienisz to w /config, w ustawieniu „Project instructions”). Projekt z samym AGENTS.md działa więc we wszystkich tych narzędziach bez dodatkowych plików. Gdy CLAUDE.md istnieje, AGENTS.md nie jest wczytywany automatycznie. Jeśli potrzebujesz obu plików, bo chcesz dopisać coś tylko dla Claude Code, treść trzymaj w AGENTS.md, a w CLAUDE.md zacznij od importu:
@AGENTS.mdPod nim dopisujesz to, co dotyczy tylko Claude Code (hooki, skille, uprawnienia). Dawne obejście, czyli dowiązanie symboliczne (ln -s AGENTS.md CLAUDE.md), przy samym AGENTS.md nie jest już potrzebne.
Szablon CLAUDE.md na start
# Nazwa projektu

Dwa zdania: co to jest i do czego służy.

## Uruchomienie i testy
- serwer: …   (z katalogu …, port …)
- testy: …    (co musi przejść przed commitem)

## Konwencje
- commity: Conventional Commits
- …

## Pułapki (z datą i powodem)
- RRRR-MM-DD: … bo …

## Nie rób
- … bo …

## Gdzie szukać
- plan i decyzje: docs/…
- dane logowania: ~/.config/… (nigdy w repo)
Zasada na start: zacznij od /init, wytnij wszystko, co agent i tak wyczyta z kodu, a potem dopisuj po jednej regule za każdym razem, gdy agent się pomyli. Jeśli jakąś część pliku czytasz tylko przy jednym rodzaju zadań, zrób z niej skill. Jeśli reguły nie wolno złamać ani razu, zrób z niej hook. Format commitów też można wymusić w ten sposób, np. Conventional Commits. Razem CLAUDE.md, skills i hooks to spora część tego, co nazywa się harnessem agenta AI: wszystkiego, co otacza model i zamienia go w narzędzie do pracy.
Najczęstsze pytania
01Co to jest CLAUDE.md?+
02Gdzie umieścić plik CLAUDE.md?+
./CLAUDE.md), żeby trafił do gita i działał dla całego zespołu. Ustawienia osobiste, wspólne dla wszystkich projektów, idą do ~/.claude/CLAUDE.md. Pliki w podkatalogach są wczytywane, gdy agent pracuje na plikach z tego katalogu.03Czym różni się CLAUDE.md od AGENTS.md?+
@AGENTS.md i to, co dotyczy tylko Claude Code.